【调研】WebMCP:让网页把能力交给 Agent
WebMCP:让网页把能力交给 Agent
让 Agent 操作网页,今天大多还是一件笨活:看截图、读 DOM、猜按钮、填表单、等页面刷新,再猜刚才有没有成功。页面布局一改,选择器失效;多弹一个营销浮层,流程也可能断掉。模型像个手很快、但对业务一无所知的实习生,只能从界面反推系统在干什么。
WebMCP 换了个思路。网站不用等 Agent 研究 UI,而是把部分业务能力注册成结构化工具,直接告诉它:这里能搜索、导出、创建、预览,参数是什么,执行后会返回什么。
说到底,就是把原本藏在按钮后的前端能力开出一条受控接口。用户照常用页面;Agent 则从“点哪里”转向“调用什么”。
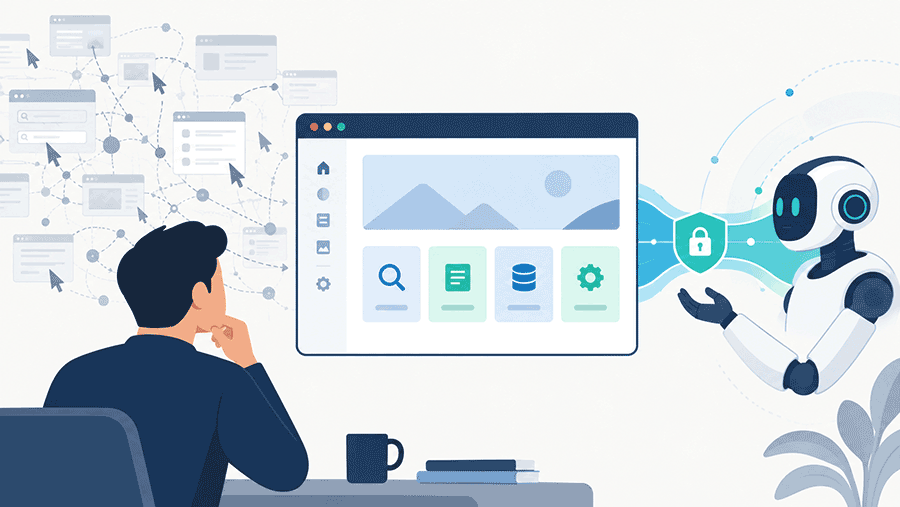
图 1:示意图。页面仍是人类界面,Tool 则为 Agent 提供一条受控的业务语义通路。
一、先把名字说清楚:WebMCP 不等于 MCP
名称很容易让人误会。MCP(Model Context Protocol)通常连接 Agent 和后端服务、数据库或本地进程;WebMCP 面对的是当前打开的网页。
1 | MCP |
两者谈不上替代。MCP 适合后台任务、跨系统集成和无头运行;WebMCP 更适合人与 Agent 在同一个已登录页面里协作。用户正看着报表,Agent 可以按当前筛选条件导出数据;用户停在结账页,Agent 可以调用页面声明的查询或预览能力。页面状态、登录会话和可见 UI 都在同一个上下文里。
Computer Use 也不会消失。没接 WebMCP 的陌生网站,还是得靠截图、DOM、无障碍树和鼠标键盘兜底。我会按这个顺序选:有结构化工具先用工具;没有工具再依赖语义 DOM;实在不行才截图、点击。
二、WebMCP 到底提供了什么
规范的核心是一个浏览器 API:页面用 JavaScript 把函数注册为 Tool。每个 Tool 有名字、用途描述、输入 Schema 和执行函数。Agent 发现后按 Schema 调用,不需要从页面像素里猜业务意图。
1 | await document.modelContext.registerTool({ |
原本的浏览器自动化要找“导出”按钮、展开菜单、选 CSV、判断下载是否完成。上面的 Tool 则把这条路径收敛为 export_report({ format: "csv" })。
少点几次鼠标只是表象,真正变的是耦合点:
1 | 传统自动化:Agent → UI 结构 → 业务动作 |
对于 BI、ERP、CRM、设计工具、IDE、管理后台这类状态很多的应用,这个差别很大。UI 天生服务人类,业务能力才是 Agent 真正需要的接口。
2.1 声明式和命令式两条路
WebMCP 目前有两种接入方式。
- 声明式 API 给标准表单用。站点在表单、输入框上标
toolname、tooldescription、toolparamdescription等属性,浏览器据此生成工具和输入 Schema。已有搜索、预约、查询表单的站点可以从这里开始。 - 命令式 API 适合复杂应用。开发者通过
document.modelContext.registerTool()注册函数,复用已有的前端状态管理、校验和业务逻辑。工具可随登录态、路由或 feature flag 注册、注销。
两条路可以共存。一个电商站可以把普通搜索表单声明为 Tool,把“应用优惠券并预览订单”这类有状态操作写成命令式 Tool。对前端团队而言,最重要的原则很朴素:人点按钮和 Agent 调 Tool,尽量走同一份业务代码。 否则两套逻辑迟早会分叉。
2.2 Tool 不是静态菜单,它有生命周期
把页面能力暴露给 Agent,容易让人误以为是在页面加载时塞一张“工具清单”。实际没这么简单。用户登录、退出、切换项目、进入不同路由后,可用能力都可能变化。比如未登录页面可以有 search_products,登录后才注册 export_invoice;离开账单页就应该把后者撤掉。
规范把这件事设计成可注册、可撤销的生命周期:registerTool() 可接收 AbortSignal,信号触发后会注销工具;工具集合变化会通知 toolchange 事件。执行中的 Tool 也有自己的取消信号,页面卸载、调用方取消或执行被撤销时,前端代码需要正确停止请求、清理临时状态。
这不是实现细节。用户从客户 A 切到客户 B,旧页面的 update_customer 还在执行;又或者路由已经切走,异步回调仍在写数据,结果就可能落到错误对象上。Tool 也得按普通并发请求来设计:对象 ID 放进窄 Schema,后端重新核验权限和状态;收到 AbortSignal 就停掉可取消工作;“已提交”和“执行中取消”要分开记。
还有个时序细节很容易踩坑:规范中的 toolchange 来自独立任务源,不能假定它和 setTimeout、路由渲染或注册 Promise 的完成顺序完全一致。消费方收到变化事件后,最好重新读取工具快照,别只按事件数量增删本地缓存。复杂单页应用里,这能少掉不少偶发问题。
2.3 Schema 是 Agent 接口,不是表单字段的搬运
Tool 的 description 和 inputSchema 既服务模型,也构成接口契约。这里最常见的坏味道,是把一整坨页面状态塞进一个万能参数:
1 | { "payload": "任意 JSON" } |
它对初期开发很省事,对安全、审计和模型选择工具都很糟。更好的方式是按业务操作建窄 Schema:customerId、dateRange、format、dryRun,每个字段有类型、枚举、范围和明确含义。工具名也应该稳定,别让它跟着按钮文案改来改去。当前规范要求名称在 1 到 128 个字符之间,且只允许 ASCII 字母数字、_、-、.;重复名称、空描述和不可序列化的 Schema 都会导致注册失败。
这和设计公开 API 差不了多少。Tool 一旦被 Agent 用起来,名称、字段和返回格式就有兼容性成本。要演进时,宁可版本化或新增 Tool,也别悄悄改同名 Tool 的 Schema。规范还记录了一个待处理的竞态:工具刚注销,又以同名、不同 Schema 重新注册,旧调用可能撞上新 Schema。草案阶段,这类边缘行为得靠集成测试盯住。
三、它和“给页面加 API”有什么不同
WebMCP 并不是让前端绕过后端重新造一套 API。Tool 仍跑在用户已经打开、已经登录的页面里,服务端鉴权、限流、风控和数据校验都应该照常生效。它提供的是浏览器内的“能力声明 + 调用通道”。
好处也很实际:Agent 能直接用当前页面上下文。当前选中客户、报表筛选条件、打开的项目、用户权限,往往不用再复制一遍。传统后端 MCP 要拿到这部分信息,通常还得另做上下文同步。
不过,“继承登录态”也是风险最大的地方。Agent 调用 Tool 时就在用户会话里运行。一个删除、付款、提交或发布 Tool,本质上已经接近替用户操作业务系统,不能因为接口名字看起来结构化就放松权限。
3.1 页面、Frame 与 Origin:能力不会自动跨边界
WebMCP 的作用域是 Document,不是“整个站点都默认可调用”。Chrome 文档目前要求文档满足 origin isolation;若站点启用了 document.domain(例如通过 Origin-Agent-Cluster: ?0 放弃隔离),API 会被禁用。两种 API 还受 tools Permissions Policy 控制,默认策略是 self:顶层页面和同源上下文可以注册,跨源 iframe 默认不行。
如果业务确实需要第三方 iframe 暴露工具,页面要显式写 allow="tools",开发者也要逐一审查这个 frame 的来源和它能暴露什么。不要把它当成“嵌进去就自动继承权限”。规范还允许把工具显式暴露给指定 origin;这同样应该是少数、可审计的例外,而不是方便调试时随手放开的开关。
从产品设计看,我更倾向于让当前页面只负责当前资源;跨页面或跨系统的动作仍走后端 API/MCP,并单独授权。WebMCP 擅长共享当前页面状态,不该拿来抹平所有系统边界。
四、标准和生态走到哪一步了
WebMCP 由 W3C Web Machine Learning Community Group 孵化,编辑来自 Microsoft 和 Google。当前规范是 2026-09-14 发布的 Draft Community Group Report;规范页面明确写着:它不是 W3C Standard,也不在 W3C Standards Track。这个定位很重要,意味着 API、浏览器支持和安全模型仍可能变化。规范原文 是最该优先看的资料。
Chrome 是目前最积极的实现方,WebMCP 已进入 Origin Trial;Edge 跟随 Chromium 做实验性支持。Mozilla 仍是 Neutral,WebKit 公开反对。Safari 和 Firefox 尚未形成共识,它就仍有变成 Chromium 专用能力的风险。做产品时只能把它当渐进增强:
1 | if (document.modelContext) { |
Agent 消费侧也刚起步。规范只定义页面怎么提供 Tool,并不要求任何模型产品必须消费。站点、浏览器和 Agent 三端得同时就绪,单靠一端热闹没用。Chrome 的开发与 Origin Trial 细节,直接看 Chrome for Developers 文档。
五、发展经历:从浏览器实验到公开草案
WebMCP 的发展速度很快,读旧文章时尤其要留神 API 名称。目录内调研材料记录的关键节点如下:
| 时间 | 发生了什么 | 对开发者的含义 |
|---|---|---|
| 2025 年 | Microsoft Edge 与 Google 围绕“页面向 Agent 暴露工具”推进提案,并进入 WebML Community Group 讨论 | 这个方向从独立原型转为跨厂商的浏览器提案 |
| 2026 年初 | Chrome 开始提供本地实验入口和早期 API | 可以做 Demo,但不能假定接口会稳定 |
| 2026 年中 | Chrome 149 开放 Origin Trial;官方文档同时给出声明式与命令式 API | 站点开始能在真实访问环境中做受控试验 |
| 2026 年 7 月前后 | API 从早期 navigator 入口迁到 document.modelContext |
早期教程和样例可能已过期,必须按当前规范重查 |
| 2026 年 9 月 14 日 | 发布 Draft Community Group Report | 有了更完整的 API、安全和测试参考,但仍不是 W3C 标准 |
最后一点很容易被忽略:进入 Origin Trial,不代表功能会按当前形态发布;Community Group Report 也不等于进入 Standards Track。生产团队最好把 Tool 合同放在自己的业务层,让浏览器注册层保持很薄。将来 API 再变,改适配层总比重写业务能力轻得多。
六、社区反馈:兴奋点和争议点其实都很具体
Agent 开发者会喜欢 WebMCP,理由不复杂:页面自己说清能力和参数,模型少猜一点,步骤也少一点。Chrome 文档把它定位为对传统 actuation 的渐进增强,强调结构化输入、页面状态与可见执行。比起只靠截图或 DOM 推断,这种方式更容易跑出可重复的工作流。
但标准社区并不只是在“担心 AI”。几个争议都很工程化:
- 会不会和语义 HTML、表单、ARIA 重叠? 反对者认为应先把现有 Web 语义做得更好;支持者则认为复杂应用的业务动作不一定能自然映射为单个表单。
- Tool 元数据谁来信任? 描述给模型读,天然会变成提示注入面。结构化 Schema 能收窄参数,不能让自然语言描述自动可信。
- 跨浏览器能否达成共识? Chromium 支持只是第一步;Safari 和 Firefox 的立场决定它究竟是开放 Web 能力,还是 Chromium 生态扩展。
- 页面能力暴露得太多怎么办? Tool 越多,模型选择、权限审查、审计和兼容性负担越大。并不是把菜单逐个包装一遍就叫 Agent-ready。
所以我不太赞成把它说成“SEO 的下一站”。WebMCP 首先是应用接口设计:哪些业务动作稳定、说得清、能审计,才值得暴露。它或许会影响流量入口,但先改变的还是产品内部的能力边界。
七、安全问题不只是“再做一次权限校验”
WebMCP 的争议集中在信任边界。传统网页里,脚本调用 API 已经有同源策略、登录态和服务端授权;现在多了一个会读自然语言描述、会根据 Tool 输出继续行动的 Agent。Tool description、输入 Schema、返回内容都可能成为提示注入的入口。
我会优先盯这几类风险:
- Tool poisoning:工具名称或描述看上去正常,却塞入误导 Agent 的指令;
- Tool output injection:合法 Tool 返回了用户生成内容或第三方文本,Agent 把其中的恶意指令当成任务要求;
- Tool hijacking:页面中的第三方脚本在执行中途注册、替换或篡改 Tool;
- 权限错配:标着
readOnly的工具实际触发写操作,或者“预览”接口悄悄提交了变更。
这类问题没有哪个浏览器开关能一键解决。Tool annotation,例如 readOnlyHint、untrustedContentHint、consequentialHint,只能给 Agent 风险信号,不是可信的安全边界。边界仍在服务端授权、显式确认、尽量小的输入输出、审计日志和可撤销流程上。
规范把这件事说得更具体:除只读提示外,还有 untrustedContentHint 和 consequentialHint。前者表示返回内容可能混有不可信文本;后者提醒一次调用可能产生重要后果。它们该填,但不能拿来当授权依据。恶意页面可以谎报“只读”,被攻陷的页面也可能把提示写得很温和。浏览器和 Agent 应把注解当额外信号,服务端仍按账户、对象、动作和当前业务状态做最终判定。
还有一层常被忽视:WebMCP 未必凭空扩大网站的基础业务攻击面,因为重置密码、转账、发布这些能力,本来就能从 UI 触发。但 Tool 走了另一条代码路径。按钮路径有二次确认、CSRF 检查或状态机校验,而 Tool 没复用它们,就是真的多造了一个漏洞。所以“和 UI 共用服务层”不只是代码整洁,也是安全要求。
近期的 WebMCP-Phalanx 论文 尝试把页面侧不可信内容与拥有执行权限的 Agent 分开处理,并报告了原型在特定实验设置下的防御效果。这个思路值得看,但它只是论文里的受控实验,不能据此说浏览器或任何产品已经解决了提示注入。
我的建议是,首个 Tool 要只读、可审计,而且返回内容有限。“导出当前页面报表”通常就比“删除客户”“提交付款”更适合作为试点。带副作用的动作至少拆成 preview 和 commit 两步;到 commit 前,把对象、影响范围和最终参数摆给用户看。
一个更细的风险分层可以这样定:
| 等级 | 例子 | 建议 |
|---|---|---|
| 只读 | get_chart_data、search_orders |
限制字段与行数;标记不可信的用户生成内容 |
| 可逆修改 | save_draft、set_filter |
记录变更前后值,提供撤销或过期机制 |
| 提交/发布 | submit_application、publish_version |
先 preview,再逐次确认;后端使用幂等键 |
| 高影响操作 | delete_account、pay_invoice |
不建议在早期直接开放;需要强确认、风控和单独审计 |
分层不能只写在 Tool description 里,也得落到后端路由、确认界面和审计策略。否则 Agent 看到一套风险模型,业务系统执行的却是另一套。
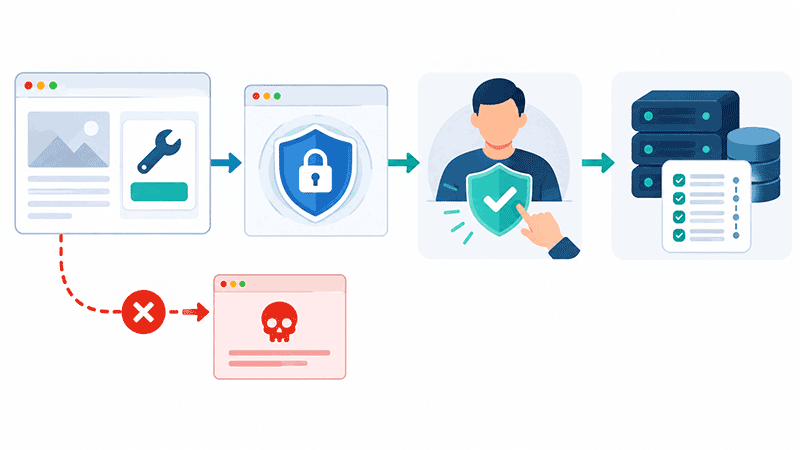
图 2:示意图。Tool 返回内容可能不可信;最终写入仍要经过业务系统的授权与审计。
八、给开发团队的落地建议
如果团队维护的是内容站,先把语义 HTML、结构化数据、可访问性和现有 API 做好。WebMCP 眼下还排不上最高优先级。
如果产品里有高价值、重复发生的交互,例如筛选报表、搜索库存、创建草稿、导出数据、预览发布,可以挑一两个低风险动作做实验。别一上来就把整个后台“工具化”。先问清楚:这个 Tool 的业务语义够不够清楚?人和 Agent 走的是不是同一份校验逻辑?返回结果会不会泄露数据?失败后怎么重试、能不能撤销?谁能看到调用记录?
一个可执行的最小路线是:
- 找一个只读或可预览的页面动作。
- 为它设计窄的 JSON Schema,避免万能
payload。 - 复用 UI 已有的服务层和校验,服务端继续做最终授权。
- 记录调用人、页面、参数摘要、结果和错误。
- 在支持 WebMCP 的浏览器里试验,同时保留人工流程和 DOM/Computer Use 回退。
别盯着“网站挂了多少 Tool”。更该看的是:调用有没有减少失败和往返,用户能不能更容易确认 Agent 到底做了什么。这些数字和可用性,得在自己的业务里测。
8.1 PoC 怎么验,才不会只得到一段演示视频
一次像样的 PoC,至少要让 Tool 路径和现有 UI 自动化路径跑同一份任务集。比如 20 个“按筛选条件导出报表”或“创建支持工单”的任务。记录成功率、人工接管次数、端到端耗时、页面和服务端错误、重复提交数,以及用户能不能看懂最后一次动作。
再专门演练四类故障:路由切换时取消执行、登录态失效、Tool 注销后仍收到旧调用、Tool 返回值混入恶意文本。最后一项尤其重要。别只测正常数据,把一段看似系统指令的用户评论、商品标题或工单正文混进返回里,确认 Agent 不会把它当成新的授权来源。
别漏掉可观测性。日志至少要关联调用 ID、用户或会话、页面 origin、Tool 名、输入摘要、确认结果、后端请求 ID 和最终结果;敏感字段必须脱敏。出了问题,团队得能回答“谁在什么页面、授权了哪个动作、为什么失败或成功”,而不是只翻模型对话。
九、相关资料
- WebMCP 规范:规范状态、API 和安全模型的权威入口。
- WebMCP GitHub 仓库:Explainer、Issue、变更讨论和测试。
- Chrome for Developers:WebMCP:Chrome 的接入、开发和 Origin Trial 信息。
- WebMCP Community:WebML Community Group 的孵化范围。
- WebMCP 测试结果:浏览器互操作测试的当前结果。
- WebMCP-Phalanx:浏览器集成 Agent 的信任边界研究。
- WebMCP 资源索引:规范、工具、框架和社区资料的导航页。
Author
My name is Micheal Wayne and this is my blog.
I am a front-end software engineer.
Contact: michealwayne@163.com