【调研】从 Generate 到 Decide:Jev、System One Models 与 Agent 决策层
从 Generate 到 Decide:Jev、System One Models 与 Agent 决策层
TypeSafe AI 将 Jev 定义为首个公开的 System One Model:输入状态与一组预定义问题,直接输出 Choice、Score、Noul 等类型化结果及其概率。它试图把高频语义判断从
generate()中拆出来,变成软件可以直接消费的decide()。这篇文章重点回答六个问题:
- 为什么 Agent 时代会出现 Decision Model 这类新需求?
- Jev 与 Structured Output、分类器、Reward Model 到底有什么区别?
- Parallel Sampler、RLCD、Calibration 等概念意味着什么?
- “193× faster”“444× cheaper”“Zero Hallucination”应该怎样理解?
- 发布数天后,社区真正把 Jev 用在了哪些场景?
- 如果这种模型形态成立,Agent Runtime 是否需要独立的 Decision Runtime?
给技术决策者的 TL;DR
Jev 是把“该选哪个、是否通过、是否升级”这类有限候选的语义判断,做成可被程序直接消费的decide()调用的模型/API 形态,而非通用聊天或推理模型。优先在 Agent/Skill 路由、结果验收与升级、循环停止/重试等高频且答案空间可预定义的场景验证;不要把它用于开放式规划、不可逆授权或安全关键的快速控制。两项核心风险是:其 confidence 是否在真实业务与分布外输入上仍然校准,以及 Frontier LLM 的 function calling、structured output 与缓存优化会否把其延迟/成本优势压缩到不足以形成独立品类。
信息可信度说明
本文引用的信息大致分成四类,可信度依次递减:
| 类别 | 内容 | 用途与限制 |
|---|---|---|
| A:官方 / 一手事实 | API、模型定位、价格、团队、官方 benchmark 方法 | 事实性较强,但官方 benchmark 方法论本身仍需独立验证 |
| B:第三方平台数据 | 如 Vercel leaderboard | 可用于判断 adoption signal 与 traffic shape,不能直接推导模型质量 |
| C:独立社区实验 | 使用场景、工程经验、失败模式、benchmark 线索 | 多数 launch-week 项目样本较小,不能视为生产证据 |
| D:SEO / Launch Amplification | 发布期营销性文章与转载 | 不作为独立效果证据 |
后文出现的具体数字与结论,均可按来源对照此表估算可信度。
术语速查
| 术语 | 含义 |
|---|---|
| Choice / Score / Noul | Jev 的三种输出类型:有限候选选择 / 数值评分 / 0–1 真值概率 |
| Calibration(校准) | 模型给出的 confidence 是否等于其实际正确率,例如 confidence=0.9 时应有约 90% 正确 |
| ECE(Expected Calibration Error) | 衡量 calibration 好坏的常用指标,越低越好 |
| Brier Score | 另一种衡量概率预测准确性的指标 |
| OOD(Out-of-Distribution) | 训练分布之外的输入,用于检验模型泛化与 calibration 是否仍然可靠 |
| RLCD | TypeSafe 提出的训练方法名称(Reinforcement Learning for Calibrated Decisions),细节尚未完全公开 |
Part 1 · 概念与背景(一 ~ 三)
一、为什么 Agent 时代开始需要另一种模型
过去,大模型最典型的交互方式是:
1 | Human |
模型的价值主要体现为回答、写作、总结、解释和代码生成。
但当 Agent 真正进入软件工程与业务系统以后,运行方式开始变成:
1 | Software State |
一个任务可能运行几十、几百甚至几千步。
这时,大量模型调用真正在做的,是回答一系列非常小、却非常频繁的问题,目标已经不再是“生成一段好文字”:
- 当前请求应该交给哪个 Agent?
- 需要哪个 Skill?
- 应该使用便宜模型还是强推理模型?
- 当前 Loop 是否已经卡死?
- 这次失败应该 retry、replan 还是升级人工?
- 这个结果是否足以宣布任务完成?
- 是否需要再跑 E2E?
- 当前 Tool Call 是否可疑?
- 哪些上下文应该继续保留?
- 当前状态更适合本地执行还是云端执行?
这些问题有三个共同特征:
- 需要语义理解,纯规则不够;
- 答案空间通常有限;
- 不需要生成长文本。
于是一个新的工程问题出现了:
如果最终只需要一个
true/false、一个 route、一个 score 或一个有限选项,为什么每次都要让一个生成式模型经历完整的自回归解码?
这就是 Jev 所瞄准的空档。
二、规则太硬,Frontier LLM 太重
从软件架构角度看,可以把智能判断粗略分成四层:
1 | ┌────────────────────────────────────────┐ |
这四层的职责不同:
| 层次 | 擅长什么 | 不应承担什么 |
|---|---|---|
| Rule / Test | 权限、预算、格式、lint、测试、硬策略 | 模糊语义 |
| Decision Model | 分类、有限候选选择、风险分级、是否升级 | 开放式方案发现、复杂推理 |
| System-2 LLM / Agent | 根因分析、规划、代码、解释、跨工具探索 | 每一个高频小判断 |
| Human / Approval | 风险取舍、责任承担、不可逆授权 | 被模型概率绕过 |
Jev 真正试图建立的,就是中间这层:
Semantic Decision Layer
如图 1 所示,这一层只能在 L1 硬规则设定的边界内工作;它的输出可以触发复核或升级,不能替代权限、审批或确定性安全约束。
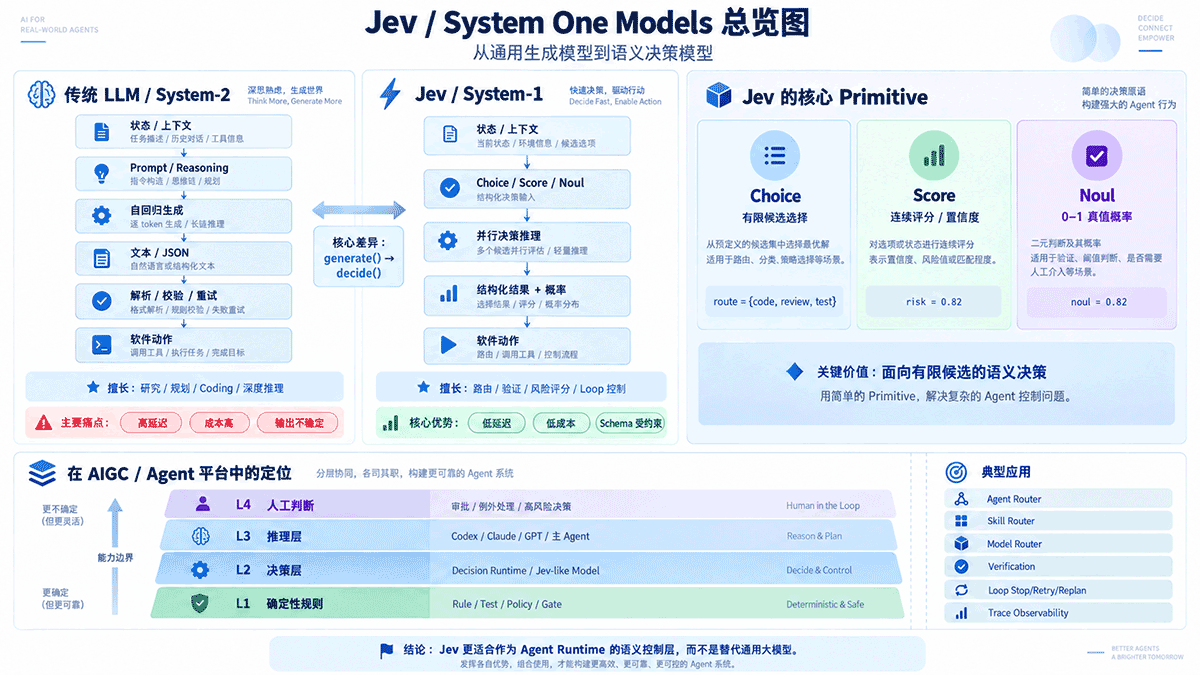
图 1:基于公开接口与本文架构推导绘制。Jev 的输出受 schema 约束,但 schema 合法不等于判断正确;该图不描述 TypeSafe 未公开的内部实现。
三、TypeSafe AI 与 Jev 的背景
3.1 TypeSafe AI
TypeSafe AI 是一家位于旧金山的 AI 公司,约 2024 年成立,在 stealth 状态开发约两年后,于 2026 年 9 月 15 日正式发布 Jev。
TypeSafe 同时宣布获得 4000 万美元 Seed 融资,由 DCVC 领投。
官方资料:
- TypeSafe:https://typesafe.ai/
- Introducing System One Models & Jev:https://typesafe.ai/blog/introducing-system-one-models-and-jev
- Team:https://typesafe.ai/team
- DCVC:https://www.dcvc.com/news-insights/typesafe-emerges-from-stealth-with-a-new-way-of-doing-ai/
3.2 创始人 Diogo Almeida
TypeSafe CEO Diogo Almeida 曾在 OpenAI、Google Brain 任职,并且是 2022 年 InstructGPT 论文《Training language models to follow instructions with human feedback》的作者之一。
论文:
https://arxiv.org/abs/2203.02155
一些媒体会把 Almeida 描述为“ChatGPT 发明者”或“RLHF 发明者”,这类表述过于简化。
更准确的说法是:
Diogo Almeida 是 InstructGPT / OpenAI 早期 RLHF instruction-following 工作的重要研究参与者之一,这项研究直接推动了 ChatGPT 的技术演进。
TypeSafe 当前团队还包含来自 Meta / FAIR、Stripe、Airbnb、Plaid、Docker 等公司的成员。
整体画像更接近:
Model Research + Production Infrastructure + Developer Platform
3.3 为什么叫 System One
“System One”借用了 Daniel Kahneman《Thinking, Fast and Slow》中 System 1 / System 2 的认知隐喻:
1 | System 1 |
这并不是说 Jev 真正复刻了人类认知系统。
工程上更有意义的理解是:
把高频、低延迟、候选有限的判断,与昂贵、开放式的生成和推理解耦。
3.4 为什么叫 Jev
“Jev”来源于经济学家 William Stanley Jevons。
背后隐含的是 Jevons Paradox:
一种资源使用效率大幅提高后,其总使用量反而可能增加。
TypeSafe 的产品 thesis 是:
1 | AI Judgment Cost ↓↓↓ |
也就是说,当一次语义判断便宜到接近普通软件调用时,开发者会在过去根本不会使用 AI 的地方加入智能判断。
Part 2 · 技术机制(四 ~ 十三)
本章术语预览:Choice 是在预先给定的候选中选择;Calibration 是“90% 的置信度是否真的约有 90% 正确”;ECE 与 Brier Score 是检验这种一致性的指标;OOD 指未见过或显著变化的输入分布;RLCD 是 TypeSafe 对其训练方法的命名,公开细节仍有限。下面首次出现这些术语时会结合具体用途说明。
四、Jev 到底是什么
Jev 的核心产品定义可以压缩成一句话:
Unstructured state in, typed probabilistic decisions out.
传统生成式模型:
1 | State / Context |
Jev:
1 | State / Context |
关键变化是:
1 | generate() |
五、三种核心 Primitive
TypeSafe 当前主要暴露三类 Decision Primitive。
| Primitive | 含义 | 软件类比 |
|---|---|---|
| Choice | 在预定义候选中选择 | semantic enum |
| Score | 在定义好的尺度上评分 | fuzzy numeric function |
| Noul | 0–1 的真值概率 | probabilistic boolean |
例如:
1 | state: |
结果可以直接被程序消费,不需要模型生成自然语言解释。
六、Decision Contract:比 Prompt 更重要
真正可生产化的 Decision Model,不应该只有一句“帮我判断一下”,而需要一个可复用、可校验的 Decision Contract。
可以定义为:
1 | Decision Contract = |
至少包括:
| 要素 | 作用 |
|---|---|
| Stable Decision Key | 便于日志、回放、统计和迁移 |
| State Boundary | 明确哪些上下文进入模型 |
| Candidate Space | 决定模型可以输出什么 |
| Criteria | 把模糊问题改写成可复核标准 |
| OTHER / UNKNOWN / ABSTAIN | 避免 forced choice |
| Consumer | 结果用于展示、建议、路由还是自动动作 |
| Version | schema、截断、criteria 改变都可能改变分布 |
这是 Decision Model 与随意 Prompt 调用之间非常重要的工程差异。
6.1 把 Contract 设计成可治理的接口
Contract 的目标不是把 prompt 写得更长,而是让同一种业务判断可以被稳定地调用、回放和替换。一个实用的约束是:Decision Key 标识“业务判断是什么”,Version 标识“当前如何判断”。
| 设计点 | 建议 | 常见误区 |
|---|---|---|
| Stable Decision Key | 使用 decision.<业务域>.<判断意图>,例如 decision.support.ticket_route;保持长期稳定 |
把 provider、阈值或 v2 写进 key,导致同一判断无法做跨版本统计 |
| Version | criteria、候选、状态截断、标签定义任一变化都递增版本;日志同时保存 key 与 version | 只在更换模型时版本化,忽略 prompt/schema 改动造成的分布变化 |
| State Boundary | 明确输入字段、截断策略、缺字段默认值和脱敏规则 | 把整段对话或不可复现的实时上下文直接传入 |
| Consumer Policy | 为展示、建议、自动动作分别定义阈值和 fallback | 让下游业务各自解释同一个 probability |
Criteria 要写成可复核的判定条件,而不是换一种说法的模糊问题。
| 模糊问法(before) | 可复核标准(after) |
|---|---|
| “这个工单紧急吗?” | “若存在服务不可用、数据泄露迹象、资金损失进行中任一证据,选 P1;仅有一般功能受阻选 P2;证据不足选 UNKNOWN。” |
| “这次 Agent 完成了吗?” | “仅当要求的文件存在、目标测试通过、输出中无未处理错误,且没有声明待人工完成事项时选 PASS;否则选 REVIEW 或 FAIL。” |
| “该用强模型吗?” | “若任务需要跨多个来源推理、修改不可逆资源或现有 fast-model 置信度低于阈值,选 FRONTIER;其余选 FAST。” |
OTHER、UNKNOWN 与 ABSTAIN 也不应混用:OTHER 表示输入属于候选空间之外但可确认存在的类别;UNKNOWN 表示证据不足或状态缺失;ABSTAIN 表示模型/策略不应作答,例如 OOD、冲突信号或低校准桶。三者的 Consumer Policy 可以不同:OTHER 进入人工归类或扩展候选,UNKNOWN 请求补充状态,ABSTAIN 直接走安全 fallback。
一个最小可审计模板如下;它不是 Jev 专属格式,但要求 Runtime 能完整记录这些字段:
1 | key: decision.support.ticket_route |
七、Structured Output 和 Jev 到底有什么区别
7.1 Structured Output
1 | GPT / Claude |
它本质上仍然是:
Constrained Generation
7.2 Jev
TypeSafe 的产品主张则是:
1 | Input Representation |
即:
Direct Decision Inference
这解释了为什么 Jev:
- 不需要自由文本输出;
- output 不按 token 收费;
- 可以直接返回 option probability;
- 多个独立 question 可以并行;
- 理论上具有远低于完整文本生成的延迟。
因此:
Structured Output 是“限制模型怎样说”,Jev 是“尽量不让模型说”。
八、Parallel Sampler:为什么多个问题可能很快
TypeSafe 强调 Jev 的另一个核心能力是 parallel sampler。
传统模型如果把多个判断拆成多次调用:
1 | Question A → Generation |
Jev 的目标形态是:
1 | Shared State |
对于 Agent Runtime,这一点很重要。
一次 Loop iteration 可能同时需要判断:
1 | complete? |
如果这些判断可以共享 state 并在一次 inference 中完成,Decision Model 的优势会随着问题数量增加而放大。
九、RLCD 与 Calibration
TypeSafe 将其训练方法称为:
Reinforcement Learning for Calibrated Decisions(RLCD)
官方将其与 RLHF / RLVR 对比:
1 | RLHF |
它真正要优化的,是让置信度贴近真实正确率。单纯把 confidence 拉高没有意义:
1 | P(correct | confidence = x) ≈ x |
9.1 为什么 Calibration 比 Accuracy 更重要
假设两个模型:
1 | Model A |
如果只是离线分类,A 可能更好。
但如果是自动化系统:
1 | if (p > 0.99) autoExecute() |
Model B 可能更有价值。
因此需要观察:
- Reliability Diagram
- Expected Calibration Error(ECE)
- Brier Score
- Coverage / Error Curve
- High-confidence Error Rate
经典校准研究:
https://arxiv.org/abs/1706.04599
9.2 RLCD 仍然是 Claim,而不是已经完全被验证的突破
截至本文,TypeSafe 仍未公开足够的:
- RLCD 算法细节;
- 模型架构;
- 参数规模;
- 训练数据;
- 大规模 OOD calibration benchmark。
因此目前不能确定:
RLCD 是独立的新训练范式,还是 RL、classification、reward model 与 calibration 技术的组合创新。
更稳妥的判断是:
Calibration 是 Jev 最值得验证的能力,而不是可以直接相信的供应商属性。
十、“Zero Hallucination”到底是什么意思
TypeSafe 首页强调:
Zero Hallucinations
Jev 确实可以做到:
1 | ✓ 不产生 malformed JSON |
如果:
1 | route ∈ {code, review, test} |
Jev 不会回答:
1 | marketing |
但是它仍然可能:
1 | 正确答案:review |
因此更准确的表达应该是:
Zero out-of-schema generation ≠ Zero semantic error
甚至从生产系统角度看:
“错误但完全合法”的结果,往往比 malformed JSON 更难发现。
十一、193.6× faster / 444.6× cheaper 怎么看
TypeSafe 官方在 workflow eval 中给出了:
- 193.6× faster
- 444.6× cheaper
这些数字不应理解成:
“所有任务 Jev 都比 GPT 快 193 倍。”
官方 workflow 包括:
- Security Incident
- Agent Trace Observability
- Invoice Processing
- Customer Service
它们本身就非常适合:
1 | 复杂流程 |
因此这些数字更适合被理解为:
证明 Jev 在 System-One-shaped workload 上存在巨大效率潜力。
而不是通用 benchmark。
官方评测:
十二、Jev 的开放与收费状态
截至 2026-09-21:
| 项目 | 状态 |
|---|---|
| 模型权重 | 闭源 |
| 官方 API | 已开放 / Early Access |
| Web Console | 有 |
| OpenRouter | 已接入 |
| Vercel AI Gateway | 已接入 |
| 官方本地部署 | 未公开 |
| 输入 | 以文本 / 结构化文本状态为主 |
| 输出 | Typed Decisions |
| Input Price | 约 $0.042 / 1M tokens |
| Output | 免费 |
TypeSafe 首页将价格写成:
$42 / 1B input tokens
这意味着在很多高频 decision workload 中,成本已经低到不再是主要障碍。
真正需要验证的是:
- 中文表现;
- 本业务准确率;
- calibration;
- OOD;
- 长上下文;
- high-confidence error;
- 数据安全。
十三、Jev 到底“新不新”
13.1 质疑方:这不就是分类器吗?
从技术形态上看,Jev 与很多已有技术都有相似之处:
- BERT classifier
- NLI
- Cross Encoder
- Reward Model
- Reranker
- Energy-based Model
- Logits Readout
所以“有限答案集合 → probability distribution”本身显然不是新的数学思想。
13.2 支持方:真正的新价值是 Generalized Decision Model
传统 classifier 通常是:
1 | 固定 Task |
Jev 想实现:
1 | Natural-language Instructions |
每个新任务都跳过重新训练。
这才是它真正需要证明的能力:
General-purpose + task-configurable + calibrated decision model
13.3 一个更合理的评价
目前更合适的说法是:Jev 的学术 novelty 尚有争议,但其产品 abstraction 很清晰。
“TypeSafe 是否发明了 classifier”这个问题意义不大,真正值得追问的是:
“是否真的存在一种跳过任务级 fine-tune、足够通用、足够快、且概率足够可信的 Decision Model,可以成为软件基础设施?”
Part 3 · 生态与应用场景(十四 ~ 十九)
十四、Jev-like 生态已经迅速出现
Jev 发布后几天内,社区已经出现多条实现路线。
| 路线 | 代表项目 | 思路 |
|---|---|---|
| 双向 Encoder + Decision Head | Laya / Verdict / Von | 一次 forward 直接评分 |
| Small LLM + Readout Head | Kev | 复用预训练知识,不生成文本 |
| LLM + Logits Readout | OpenJev / Simple-Jev | 直接读取候选 token logits |
| Shared Prefill / Option Scoring | daseinlabs open-jev | 共享 KV Cache 批量候选评分 |
| Diffusion Backbone | DiffusionGemma OpenJev | 利用并行生成机制做决策 |
| Generic Adapter | LitJev 等 | 把现有模型包装成 Decision API |
其中 Laya 当前社区开发非常活跃,已经出现 Calibration temperature 持久化、OpenAI-compatible API、高 cardinality choice、GPU fast path 与 benchmark harness 等工作。
这说明:
Decision Model 这一形态正在快速被开源社区拆解和复现。
但这不等于这些项目已经拥有与 Jev 相同的 calibration、泛化或生产性能。
十五、一个重要开放问题:它是“新模型层”,还是“新 API / 推理方式”
随着 Jev-like 实现增多,开始出现两类路线:
1 | Jev-like Ecosystem |
于是长期需要回答:
Decision Model 是否真的需要独立训练一类模型?还是改变现有模型的 inference / readout 方式就够了?
这个问题目前还没有答案。
十六、发布数天后,社区真正拿 Jev 做什么
相比官方 demo,社区使用已经开始形成非常明显的模式。
最值得关注的地方,比“分类文本”更进一步:
Continuous Decision Loop
即:
1 | State |
16.1 Agent / Skill / Model Router
Agent Router:User Request → Jev → Research / Code / Browser / Data / Human
Skill Router 则位于 retrieval 之后:Request → Candidate Skills → Jev → Best Skill。它与 embedding retrieval 问的问题不同:Embedding 回答“哪个 Skill 和请求最相似”,Decision Model 回答“哪个 Skill 最适合完成当前任务”。
Model Router:Task → Jev → Fast / Normal / Frontier
比总体 Accuracy 更值得盯的指标是:
Under-routing Rate
即:有多少真正需要强模型的任务被错误送给了弱模型。
16.2 Verification / Gate
Agent Output → Jev → pass / review / escalate
例如:
- 是否真的完成任务;
- 是否需要高级 Code Review;
- 是否需要 E2E;
- 是否需要人工复核;
- 是否满足 rubric。
逐渐形成一个很有价值的模式:
1 | Rule |
16.3 Loop Control
Iteration State → Decision → continue / retry / replan / stop
同时检测:
- 是否反复执行同一策略;
- 是否出现 A ↔ B 震荡;
- progress 是否持续下降;
- marginal value 是否已经接近 0。
这里的推荐闭环(见图 2)是目标架构,不是 TypeSafe 已上线的控制实现:Decision Model 只能提高复核等级、触发重试或升级,不能降低 L1 硬规则,也不能绕过合并、发布或人工审批。
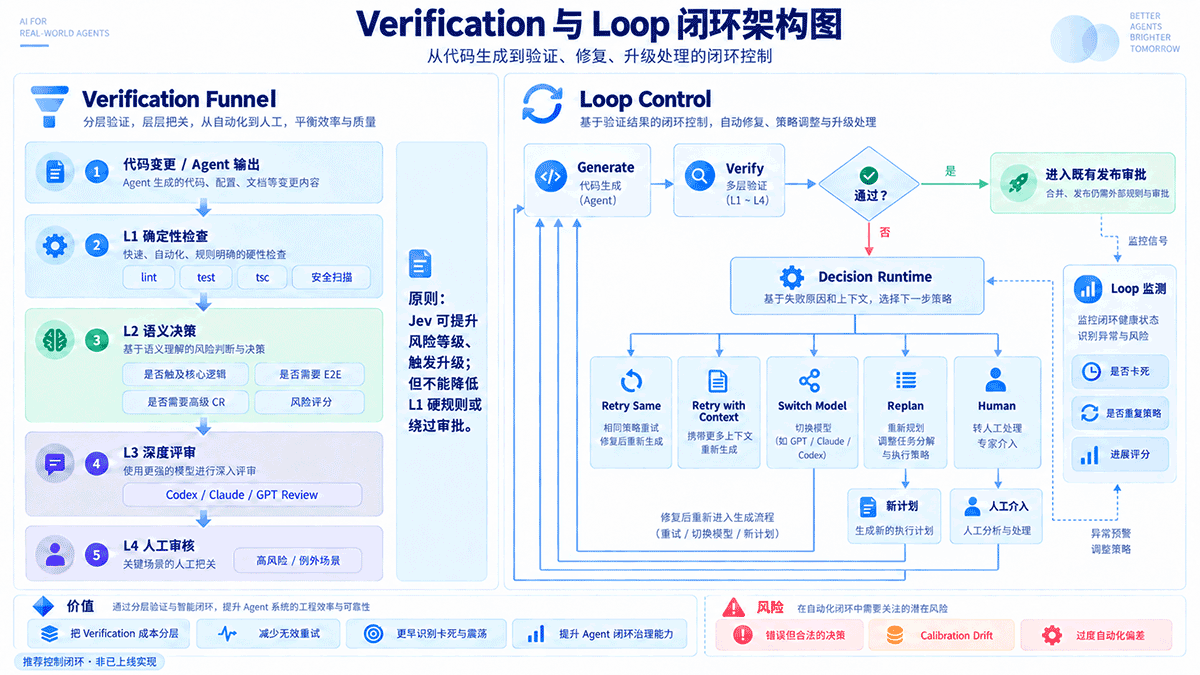
图 2:推荐控制闭环,非已上线实现。模型判断只决定复核、重试、切换模型、重规划或人工升级;合并与发布仍受既有规则和审批系统控制。
16.4 Context Keep / Drop
长程 Agent 会积累大量旧工具结果和过时上下文。Decision Model 做三选一判断即可(KEEP / DROP / RELEVANT),不重新总结内容。
16.5 不应把“能调用”误写成“适合自动化”
发布早期的社区项目能提供可行性信号,却很少构成失败率或生产可靠性的证据。因此不能把缺少公开失败报告理解为已经安全。以下边界比“又一个可用场景”更重要:
- 开放式问题:候选无法合理预定义、需要提出新方案或解释根因时,应交给 System-2,而不是把复杂推理伪装成 Choice。
- 不可逆或安全关键动作:资金划转、生产删除、飞行姿态稳定、医疗/法律结论不应由 Decision Model 单独授权;它最多提出升级建议。
- 没有可验证标签的判断:若无法定义 ground truth,就不能检验 accuracy、calibration 或 drift;先做人工辅助与数据采集,而非自动化。
- 分布快速变化的领域:新攻击手法、极端市场状态或界面大改后,历史 calibration 可能失效,必须降级到
ABSTAIN/ fallback。
十七、从分类器走向真实连续控制
17.1 量化 / Crypto Trading
社区已经有人把 Jev 放进交易循环:Order Book → Structured Market State → Jev → buy / sell / hold → New Market State。jev-trader 甚至尝试让每个 Monad block 都进行一次 decision。
这类项目目前能证明的是延迟足够低、成本足够低、能进入实时 decision loop。不能证明的是 Jev 具有可持续交易 alpha。因此这些案例更适合作为 Realtime Closed-loop Control Benchmark。
17.2 Mario / Doom / StarCraft / Snake / Tetris
Environment State → Decision → Bounded Action → Environment State'
它们真正测试的是:
模型能否在连续状态变化中稳定做高频 tactical decision。
17.3 无人机
合理架构不是 Jev → motor 直接驱动,而更像分层控制:
| 频率 | 层级 |
|---|---|
| 500Hz | Flight Controller |
| 50Hz | Safety / Guidance |
| 15Hz | Perception |
| 2.5Hz | Semantic Tactical Decision |
也就是说:
确定性 fast loop 负责安全,Decision Model 负责较慢的语义 tactical judgment。
这里的 2.5Hz 是分层职责的示意频率,不是 Jev 已验证的无人机 SLA。Jev 若被用于此层,应只在上层选择任务/航点/回航/人工接管等候选动作;一旦视觉、定位、链路或模型置信度异常,就由安全/导航层接管并使语义层 ABSTAIN,绝不可影响 500Hz 姿态稳定环。
17.4 Browser / Computer Use
DOM / Accessibility Tree → Candidate Actions → Jev → click / type / scroll / done → New DOM
可以形成三层分工:System-2 制定整体任务计划,System-1(Jev)在页面内选择下一动作,Code 负责执行、预算、超时、权限与恢复。
17.5 Home Assistant / Semantic Rule Engine
Sensor State → Decision Model → probability → Automation
它说明 Decision Model 的潜在市场不只在 Agent,还可能演化为:
Semantic Rule Engine
17.6 Semantic Database
社区甚至开始探索:
1 | SELECT * |
也就是把 WHERE deterministic_condition 扩展成 WHERE semantic_condition。
十八、六种通用 Decision Pattern
| Pattern | 结构 | 说明 |
|---|---|---|
| A:Route | State → Decision → Agent / Model / Tool / Skill | 按语义把请求分发到不同处理单元 |
| B:Gate | Output / Action → Decision → pass / review / block | 对已产出结果做通过/拦截判断 |
| C:Escalate | Cheap System → Decision → confident? → 是则 accept,否则升级到 System-2 / Human | 用置信度决定是否需要更强能力介入 |
| D:Control | Execute → Observe → Decision → continue / retry / replan / stop | 驱动循环的下一步动作 |
| E:Map | 大批量 Records → Decision Model → labels / scores | 对海量数据做批量语义标注 |
| F:Observe | Prompts / Traces / Tool Calls → Decision Model → risk / failure / quality / anomaly | 对系统运行痕迹做持续质量与风险监测 |
十九、Decision Model 最重要的失败模式
19.1 错得非常合法
1 | { |
格式完全正确,但可能语义错误。
19.2 Forced Choice
如果候选只有:
1 | billing |
而真实输入是:
1 | legal dispute |
模型可能被迫选择一个最接近的错误类别。
因此生产 Decision Contract 应优先考虑:
1 | OTHER |
19.3 Calibration Drift
Calibration 必须按:
- task
- domain
- language
- model version
- time window
持续监测。
19.4 Cross-decision Inconsistency
多个 parallel question 可能出现:
1 | complete = false |
因此 Decision Runtime 仍需要:
Deterministic Constraint Layer
19.5 把 Reasoning 问题伪装成 Choice
一个很实用的判断原则是:
Answer Space 能合理预先定义时,才优先使用 Decision Model。
19.6 Automation Bias
更稳妥的 UI 应同时提供:
1 | Model Confidence: 97% |
Part 4 · 架构建议与落地路径(二十 ~ 二十三)
二十、为什么需要 Decision Runtime,而不是直接集成 Jev
如果每个业务直接:
1 | jev.choice(...) |
很快会遇到:
- schema 散落;
- threshold 不一致;
- provider 锁定;
- 无法 replay;
- 无法 A/B;
- 无统一 fallback;
- 无法做 calibration dashboard。
更合理的架构是:
1 | Decision Runtime |
Jev 只是一个 DecisionProvider。
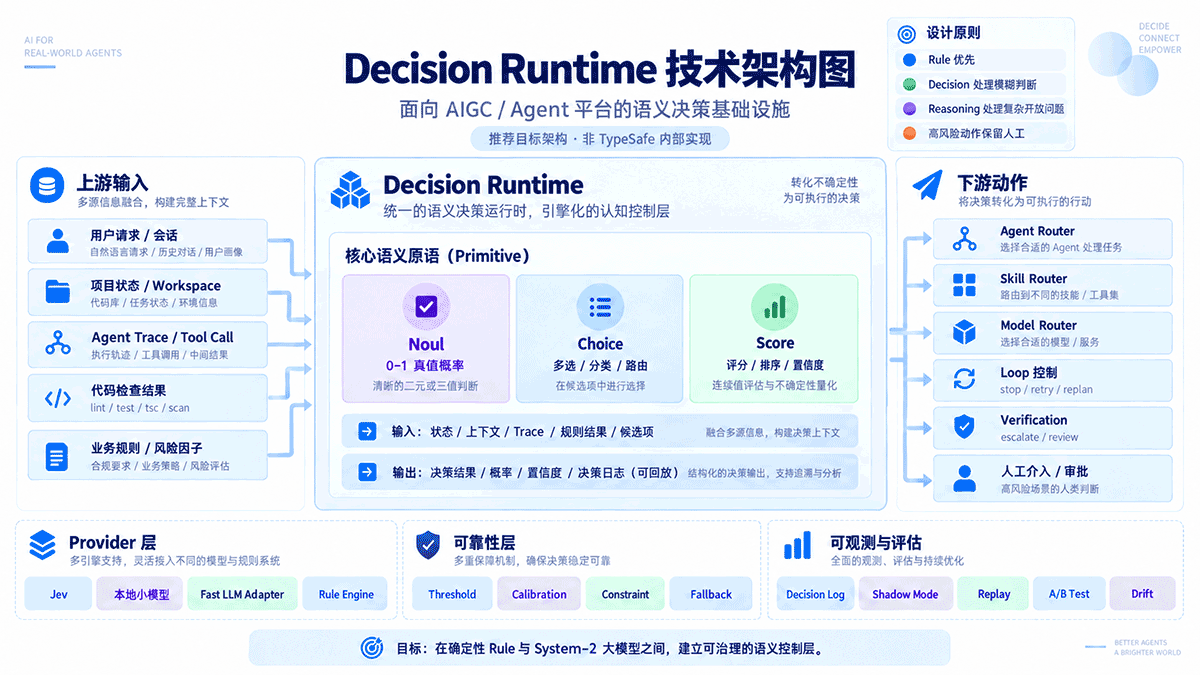
图 3:推荐目标架构,非 TypeSafe 内部实现。规则优先;Decision Provider 处理有限候选的语义判断;复杂开放问题与高风险动作仍升级至推理模型或人工。
二十一、Decision Runtime 应该包含什么
1 | Decision Runtime |
二十二、在 Agent 系统中最值得优先验证的场景
| 优先级 | 场景 | 原因 |
|---|---|---|
| P0 | Skill Router | 候选清晰、风险低、容易 benchmark |
| P0 | Model Router | 可以直接量化成本与质量收益 |
| P0 | Trace / Session Classification | 数据量大、适合离线评测 |
| P0 | Verification Escalation | cheap-confirm-escalate 模式成熟 |
| P1 | Loop stop / retry / replan | 非常符合 bounded decision |
| P1 | Context keep / drop | 长程 Agent 高价值 |
| P1 | AgentTeam delegation | 可减少过度 delegation |
| P2 | Browser action selection | 很有潜力,但要验证长程稳定性 |
不建议第一阶段直接交给 Decision Model:
- 自动生产发布;
- 权限授予;
- 安全豁免;
- 核心资金操作;
- 不可逆数据库写;
- 高风险交易授权。
二十三、如何做一个真正有意义的 PoC
PoC 要回答的问题比“API 能不能跑通”深一层:
这类 Decision 是否值得从 Rule / LLM 中独立出来?
Phase 1:Contract
定义:
- State
- Candidates
- Criteria
- OTHER / UNKNOWN
- Ground Truth
- Consumer
- Risk
- Fallback
Phase 2:Offline Replay
同一数据集比较:
1 | Rule |
至少评估:
| 维度 | 指标 |
|---|---|
| Quality | Accuracy / Precision / Recall |
| Calibration | ECE / Brier / Reliability |
| Automation | Coverage @ Threshold |
| Risk | High-confidence Error |
| Performance | P50 / P95 / P99 |
| Cost | $ / 1M decisions |
| Stability | Repeat consistency |
| OOD | Unknown / new domain |
| Language | 中英等语言切片 |
Phase 2.1:先确定数据,而不是先跑模型
最有价值的数据通常不是“通用 Decision 数据集”,而是业务已有的、可追溯结果的历史事件:工单最终队列、人工复核结论、Agent trace 的真实完成状态、发布后的回滚/事故记录。按时间切分训练/调参与测试集,避免同一事件或后验结果泄漏到 replay;并单独保留新业务线、语言、渠道或版本作为 OOD 切片。
| PoC 类型 | 数据与验证边界 |
|---|---|
| Router | 首选历史请求、实际使用的 skill/model 与完成质量;公开分类/检索数据只用于验证接口与候选空间,不能替代真实的 under-routing 成本。 |
| Verification / Gate | 首选 PR、任务或工单的人工验收与后续缺陷;合成数据可覆盖边界、缺字段和冲突证据,不能替代“通过是否真的安全”的业务标签。 |
| Loop Control | 首选 Agent trace、重试次数、人工介入与最终结果;合成死循环、震荡与预算耗尽轨迹只能补充,不能替代真实工作流中的恢复行为。 |
Synthetic data 适合覆盖罕见候选、OTHER/UNKNOWN/ABSTAIN、格式错误和 OOD 压力,但只能作为补充;若它由同一个 LLM 生成并标注,模型可能只是在拟合生成器偏好。最小可行数据集也不宜用单一条数承诺:每个会触发自动化的候选、阈值桶和关键 OOD 切片都应有足以估计错误率的独立样本;罕见而高损失的错误宁可先保持 shadow,直到积累到可审计的标签。
Phase 2.2:在现有 Agent 栈中接入 Decision Runtime
不要把 Decision Model 直接散落在 LangChain、LlamaIndex 或 Vercel AI SDK 的每条链路里。更稳妥的接入点是一个 provider-neutral 的 DecisionRuntime:上游传入 Contract 与 state,下游只接收已通过 policy 的 choice / probability / fallback;日志统一保存 key、version、provider、阈值与最终结果。
1 | // 示意代码:runtime 负责 provider、阈值、fallback 与审计,不绑定某个框架的专属 API。 |
- LangChain / LlamaIndex:把
decisionRuntime.decide()包装为 chain/workflow 中的一个普通步骤;它应在 retrieval 之后、昂贵 Agent 或 tool loop 之前运行。后续节点读取已类型化的 choice,不再从自然语言中解析路由结果。 - Vercel AI SDK:把 decision 放在
generateText()/streamText()之前,用其结果选择 model、toolChoice、预算或是否升级;生成调用仍由 AI SDK 管理。这样可以复用既有 provider 抽象和 telemetry,而 Contract、fallback 与 calibration 记录仍归 Runtime 所有。
该模式不假设任何框架已经提供 Jev 的原生集成。若某 provider 后续提供专属 adapter,只应替换 Runtime 内的 provider 实现,不能让业务调用方感知其 SDK 差异。
Phase 3:Shadow
1 | Production Event |
Phase 4:Guarded Automation
只开放:
- 低风险;
- 可逆;
- 有 fallback;
- 有 budget;
- 有 circuit breaker;
的动作。
Part 5 · 展望与风险(二十四 ~ 二十八)
二十四、采用速度:Jev 真的很火,但应该怎样读数据
Vercel 披露:
Jev 上线 AI Gateway 24 小时内,接近 13% 的付费团队尝试使用。
截至 2026-09-20 的 Vercel leaderboard:
1 | Jev: |
这个组合非常有意思。
它没有占据大量 token:
1 | Token Volume ≈ 2% |
但占据非常多请求:
1 | Requests ≈ 20.8% |
这与 Jev 的产品形态高度一致:
高频、小输入、短输出甚至无生成输出的 decision calls。
但这些数据只能证明:
launch adoption 很强。
不能证明:
- 长期 retention;
- 生产 SLA;
- 模型正确率;
- calibration;
- 企业级稳定性。
接下来真正值得看的,是 30~90 天后的 retention。
二十五、TypeSafe 的真正护城河可能是什么
Jev 最容易被复制的是:
1 | Choice |
更难复制的可能是:
- Generalization:不同 Decision Schema 不需要重新 fine-tune;
- Calibration:Probability 真正可用于 automation threshold;
- Training Data:大量异构 Decision Tasks;
- Serving:极低 latency、高吞吐;
- SDK / Contract:形成 developer standard;
- Ecosystem:Vercel、OpenRouter、Agent Framework 等原生支持。
TypeSafe 真正需要做的可能不是:
“永远保持 Jev 1.x 最强。”
而是:
让
decide()成为和generate()、embed()、rerank()同一级的 AI primitive。
二十六、最大的战略风险
Frontier Labs 吸收
OpenAI、Anthropic、Google 完全可能提供:
1 | responses.decision() |
或 typed probability head。
这个风险已经不只是未来假设:主流 Frontier API 已能用 function calling / structured output 把“有限候选”做成程序可消费的接口,并能通过缓存、低推理强度或更小模型降低重复判断的成本。它们首先侵蚀的是 Jev 的 API 便利性 与一部分 端到端延迟/成本,但并不自动等同于一个独立的 Decision Model。
| 能力维度 | Frontier LLM + function calling / structured output | Jev 主张的 Decision Model | 对 Jev 的含义 |
|---|---|---|---|
| 强制输出形态 | 可强制工具调用或 JSON schema;OpenAI 的 tool_choice: "required" 要求调用至少一个工具 |
原生 Choice / Score / Noul 等类型化输出 | 接口差异可被较快复制 |
| 候选选择 | 可把候选编码为 enum 或工具;模型仍按生成式推理路径工作 | 面向有限候选的专门决策路径 | 必须用端到端 P50/P95 和成本实测证明优势 |
| 置信度 | 可要求分数,但分数本身不等于校准概率 | 以可用于阈值自动化的 calibrated probability 为核心主张 | 这是最关键、也最需要独立 benchmark 的差异 |
| 重复上下文 | Prompt caching 可降低重复前缀的输入成本;function calling 可避免自由文本协议 | Parallel sampler / 专用 serving 试图降低多问题决策成本 | 缓存会缩小优势,尤其是共享长状态的 Agent |
| 开放式推理 | 可在判断前检索、规划、解释与调用工具 | 有意不覆盖这类任务 | Jev 不应试图在该维度胜出 |
因此真正要比较的不是“能不能返回一个选项”,而是在同一 Contract、同一状态、同一阈值和同一回放集上:quality、calibration、high-confidence error、P50/P95、缓存命中后的成本,以及实现与治理复杂度。OpenAI 文档明确将 required 定义为必须调用一个或多个工具,而非校准的语义选择;Anthropic 也提供强制或任选 tool choice。这说明它们是重要的替代基线,却不能单凭 API 形态否定或证实 Jev 的 calibration 主张。
因此 Jev 的核心辩护空间不是“能不能做选择”,而是“同样做选择时,calibration 是否足够可信、延迟是否足够低、治理是否足够简单”。
Open-source Commoditization
如果 150M~1B 的小模型已经足以覆盖大量 Router / Verifier / Loop 判断,商业闭源 API 的空间会迅速被压缩。
Calibration 不成立
如果现实中发现 confidence 只是一种“看起来合理的 score”,而不是统计上可靠的 probability,Jev 的价值会从:
Production Automation Primitive
退化成:
Very Fast Semantic Classifier
仍然有价值,但战略意义不同。
二十七、未来最值得观察的五个信号
1. OpenRouter / Vercel 是否出现多个 Decisions Model
如果未来出现:
1 | Decisions: |
说明 category 已经从 TypeSafe 的产品定义变成行业类别。
2. Calibration Benchmark 是否独立出现
重点观察:
1 | ECE |
3. 本地模型是否追上
如果 400M 左右模型能稳定达到很低 latency、较高准确率和可接受 calibration,那么 Decision Runtime 很可能会大量本地化。
4. Agent Framework 是否原生出现 decide()
如果未来:
1 | generateText() |
同时存在,意义会非常大。
5. Production Retention
Jev 当前 adoption 极快。
真正重要的是:
发布 30~90 天后,Router / Verifier / Loop 场景是否仍然稳定使用。
二十八、最终判断
Jev 最容易被错误理解成:
一个比 GPT 快 200 倍的新模型。
这不是它最重要的意义。
更准确的理解是:
TypeSafe 正在尝试把 AI 从“生成内容的服务”扩展成“软件内部可以高频调用的概率决策组件”。
Jev 是否会最终成功,目前还远没有答案。
它的:
- 学术原创性;
- RLCD;
- calibration;
- OOD;
- 长期生产稳定性;
都还需要独立验证。
但它提出的问题很可能是真问题:
为什么 Agent Runtime 里的每一个语义 if/else,都要启动一个生成式大模型?
随着 Agent 系统不断增加:
1 | Router |
系统中会出现海量:
1 | route |
纯 Rule 无法理解这些灰度。
Frontier Model 又过重。
于是中间自然会出现:
Semantic Decision Layer
无论最终主导这一层的是 Jev、Laya、OpenAI、Anthropic、自研小模型,还是某种 LLM readout adapter,
从工程架构角度看:
1 | Rule Runtime |
很可能比:
1 | Everything → LLM |
更接近成熟 Agent Harness 的最终形态。
参考资料
官方 / 一手来源
TypeSafe — Introducing System One Models & Jev
https://typesafe.ai/blog/introducing-system-one-models-and-jevTypeSafe 官网
https://typesafe.ai/TypeSafe Team
https://typesafe.ai/teamTypeSafe Workflow Evals
https://evals.typesafe.ai/TypeSafe System One Docs
https://docs.typesafe.ai/concepts/system-oneVercel — Jev on AI Gateway
https://vercel.com/changelog/typesafe-ai-jev-now-available-on-ai-gatewayVercel — Jev is the fastest-adopted model in AI Gateway history
https://vercel.com/blog/ai-gateway-jev-model-launchVercel AI Gateway Leaderboards
https://vercel.com/ai-gateway/leaderboards/modelsInstructGPT
https://arxiv.org/abs/2203.02155Guo et al. — On Calibration of Modern Neural Networks
https://arxiv.org/abs/1706.04599OpenAI — Function Calling guide (
tool_choice)
https://developers.openai.com/api/docs/guides/function-callingAnthropic — Implement tool use (
tool_choice)
https://docs.anthropic.com/en/docs/agents-and-tools/tool-use/implement-tool-useAnthropic — Pricing and prompt caching
https://docs.anthropic.com/en/docs/about-claude/pricingVercel AI SDK —
generateText()
https://ai-sdk.dev/docs/reference/ai-sdk-core/generate-text
社区与开源生态
Jev Browser
https://github.com/jkudish/jev-browserHacker News — Introducing System One Models and Jev
https://news.ycombinator.com/item?id=49717558
一句话结论
Jev 尚不足以证明自己是一场“基础模型架构革命”,但它非常可能准确指出了 Agent 时代的一块真实空缺:Rule 太死,Frontier LLM 太重,中间需要一层低成本、低延迟、带概率、可组合、可治理的 Semantic Decision Runtime。
Author
My name is Micheal Wayne and this is my blog.
I am a front-end software engineer.
Contact: michealwayne@163.com